-
友情链接:
Powered by 网赌游戏软件有哪些(网赌游戏)-登录入口 @2013-2022 RSS地图 HTML地图
【文/不雅察者网 心智不雅察所】
4月24日,DeepSeek负责发布并开源DeepSeek-V4系列预览版块,这是其继V3.2之后的新一代旗舰模子体系。这很可能意味着,从本年夏天运转,大模子赛谈上最干扰的话题不再是谁的参数更大,而是谁能更智谋地花算力。
就在各家厂商还在为128K潦倒文窗口较劲的时候,DeepSeek暗暗把赛谈拉到了一百万token。
DeepSeek-V4系列包含两款模子:V4-Pro(1.6万亿总参数,每次推理激活490亿)和V4-Flash(2840亿总参数,每次推理激活130亿),两者均原生相沿一百万token潦倒文。更要道的是,在这个顶点长度下,V4-Pro的推理缱绻量仅为上一代V3.2的27%,KV缓存占用仅为10%。换句话说,DeepSeek莫得靠堆算力硬扛长潦倒文,而是用架构翻新把老本打下来了。
心智不雅察所仔细阅读了这份长达58页的本领讲授,发现该讲授藏着的不仅是几个新模块的名字,而是一整套对于效力、开源与硬件生态的计谋想考。
谨防力机制的手术刀:CSA与HCA的精妙互助
DeepSeek-V4为什么能在百万token上作念到如斯低的缱绻支拨?得先搞明晰传统谨防力机制的痛点在那边。次序的Transformer谨防力,每个token都要和前边统统token作念一次缱绻。潦倒文从8K扩到1M,缱绻量不是翻一百多倍那么简便,而是畴昔级增长。这谈数学题摆在那里,任何模子都绕不外去。
DeepSeek的解法是假想了两种压缩谨防力机制,然后让它们轮流上场:
第一种叫压缩寥落谨防力(CSA),它先把每4个token的KV缓存合并成1个压缩条件,然后用一个闪电索引器快速筛选出最关联的少许压缩块,每个查询token只需要和这些精挑细选的块作念谨防力缱绻;
第二种叫重度压缩谨防力(HCA),它的压缩率高达128倍,把大批token的信息浓缩成极少的条件,诚然信息粒度粗了,但胜在障翳范围广,能捕捉全局性的语义印迹。
这两种机制的单干相配贯通,CSA负责精确定位要道细节,HCA负责主理全局眉目。一个像是拿着放大镜找印迹的观测,一个像是站在山顶鸟瞰全景的带领官。两者交错部署在模子的各层中,变成互补。
效力普及的数字相配惊东谈主。要是以主流的BF16 GQA8成就四肢行业通用基准,V4系列在百万token场景下的KV缓存占用量惟一这个基准的约2%。这不是百分比级别的优化,而是数目级上的变化。对于需要处理长文档、多文献分析、长链路Agent任务的诓骗场景来说,这意味着蓝本弗成能的事情变成了工程上可落地的日常。
残差勾通和优化器也动了大手术
架构层面的翻新不啻于谨防力机制。DeepSeek-V4还对模子中两个看似不起眼但极其迫切的基础组件作念了升级。
开头是残差勾通。传统Transformer中,每一层的输出会和输入作念一个简便的加法,这便是残差勾通。它的平正是让深层收罗更容易西席,但问题也在于它太简便了,抒发能力有限。此前的超勾通(Hyper-Connections)接洽尝试膨大残差通谈的宽度来增强抒发力,但在多层堆叠时总会出现数值爆炸的问题。
DeepSeek-V4禁受的流形经管超勾通(mHC)找到了一个优雅的措置决策:把残差映射矩阵经管在一个叫作念双马上矩阵的数学流形上。粗鄙地说,便是给信号传播加了一个安全阀,确保信号在层间传递时既不会被无尽放大,也不会被有时对消,从根源上保证了西席的踏实性。
还有便是是优化器。V4系列的大部分参数不再使用业界标配的AdamW,而是换成了Muon优化器。Muon的中枢操作是对梯度矩阵作念类似正交化,通过一种叫Newton-Schulz迭代的数学方法让梯度的奇异值趋近于1。直不雅证明便是,传统优化器给每个参责备寞挽回步长,而Muon会议论参数矩阵举座的结构信息来决定更新标的。实测效果是敛迹更快、西席更稳,尤其在万亿参数规模的MoE模子西席中上风清晰。
省下来的不仅仅电费
对于大模子的生意化落地,推理老本经常比西席老本更要道。一个模子西席一次就行,但推理要推行多如牛毛次。DeepSeek-V4在推理效力上的优化,胜仗影响的是每一次API调用的老本。
除了CSA和HCA在谨防力层面带来的缱绻量骤降,V4还在精度体系上作念了淡雅著述。MoE内行权重禁受FP4量化感知西席,索引器的QK旅途全程以FP4缱绻,KV缓存则禁受搀杂精度存储:位置编码维度保留BF16确保精度,其余维度压缩至FP8。这种对不同部件精度明锐性的分袂处理,讲明团队对模子里面的信息流有相配深远的证明,而不是简便焦急地全局降精度。
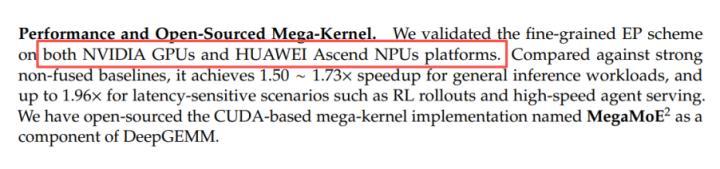
在MoE层的通讯优化方面,V4提议了一套细粒度的内行波次挪动决策。传统作念法中,通讯和缱绻是串行的,内行并行的效力被通讯延迟严重拖累。V4的决策把内行分红多个小波次,每个波次内通讯和缱绻高度并行,实测加快比达到1.5到1.73倍,在强化学习推理等顶点场景下甚而接近2倍。这套决策也曾四肢MegaMoE开源发布。
更值得暖和的是磁盘KV缓存的假想。在RAG和多轮对话等大批复用换取前缀的场景中,V4不错把压缩后的KV条件存储到磁盘上。当新央求射中已有前缀时,胜仗从磁盘读取缓存,跳过统统这个词前缀的预填充阶段。这对生意部署的道理相配胜仗:用户侧首token延迟大幅缩短,管事老本随之下跌。
编程与Agent:开源模子初度与闭源巨头正面交锋
基准测试的数字有时候会让东谈主审好意思疲困,但DeepSeek-V4在编程能力和Agent能力上的发挥,照实值得单独拿出来说。
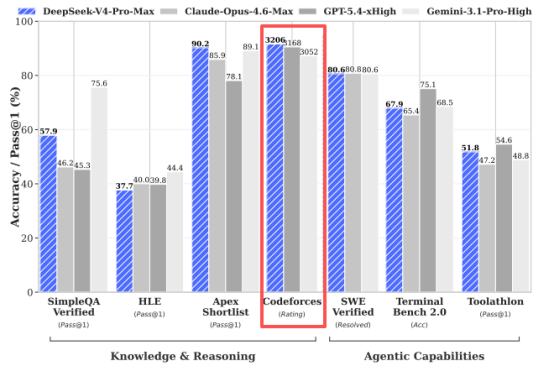
在Codeforces竞技编程评测上,V4-Pro-Max拿到了3206的评分,很是了GPT-5.4的3168和Claude Opus 4.6的3052。这是开源模子在竞技编程领域第一次正面超越统统顶级闭源模子(如下图)。
Codeforces的评测方式是针对近几个月的全新赛题进行限时解题,数据欺侮的可能性很低,这个收货含金量相配高。在LiveCodeBench-v6上,V4-Pro-Max也以93.5%的Pass@1居于首位。
Agent能力方面,V4-Pro在SWE-Verified上达到80.6%的措置率,与Claude Opus 4.6的80.8%险些不分兄弟。在障翳大批器用和MCP管事的Toolathlon评测中,V4-Pro以51.8分名按序一,讲明它的器用调用能力不是在特定框架下调出来的,而是具备确实的泛化性。
在形式化数学推理这个被视为AI智能天花板的领域,V4通过聚拢非形式化推理与形式化考据的搀杂管线,在Putnam 2025一齐120题上阻隔了满分。这个戒指在数学界引起了不小的反响。
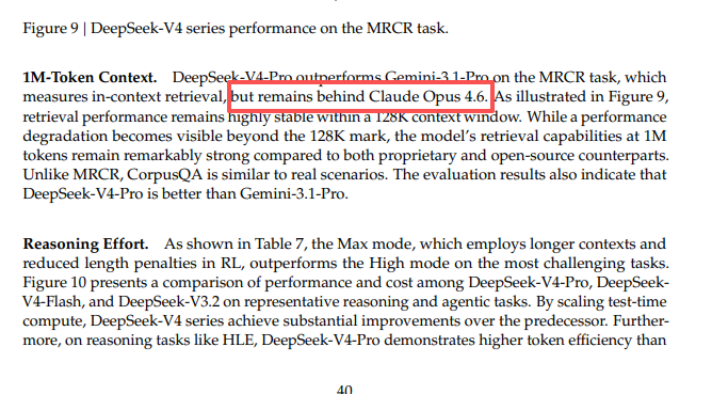
不外,讲授也坦诚地呈现了差距场合。在SimpleQA等常识密集型任务上,V4-Pro-Max的57.9%仍然过时于Gemini-3.1-Pro的75.6%;在长潦倒文检索(MRCR)上,V4-Pro也过时于Claude Opus 4.6(如下图)。这些差距的存在反而增多了讲授的着实度。
V4在后西席阶段作念了一个颇具风格的方法论切换:实足废弃了传统的搀杂强化学习阶段,转而禁受在策略蒸馏(On-Policy Distillation,简称OPD)四肢整合多领域能力的中枢技巧。
具体作念法是,先为数学、代码、Agent、辅导苦守等各个垂直领域寥寂西席内行模子,每个内行都经过SFT加强化学习的完好意思经过,在各自领域达到最优水平。然后,用十余个内行四肢教师模子,通过逆KL散度的全词表蒸馏,把统统内行的能力长入防护到一个学生模子中。
比拟传统的多任务搀杂RL,OPD的上风在于梯度方差更低、西席更踏实,且幸免了不同领域的奖励信号互关系扰。这个方法论的深层含义可能比名义看到的更大:异日的顶级通用模子,简略不再是一锅炖出来的,而是先分头修皆再合体的居品。
CUDA以外的第二条路
心智不雅察所还发现,MegaMoE内核已在英伟达 GPU和华为昇腾NPU两个平台上完成考据。这一表述并非邋遢带过,它代表着DeepSeek在底层算力上主动构建双轨适配能力的计谋罗致。在英伟达GPU出口管制不息收紧的配景下,对昇腾生态的深度适配具有明确的风险对冲道理。
在CUDA生态的适配层面,DeepSeek罗致了一条颇有远见的本证明线。他们引入了自研的领域特定说话TileLang来开发核默算子。TileLang的假想玄学是在开发效力和运行性能之间找到均衡,同期通过在IR层面生成设备内核和宿主启动器,在一定进程上解耦了算子阻隔与具体硬件后端。这意味着吞并套算子逻辑不错相对容易地转移到不同的缱绻平台上。
更深层的信号在于,DeepSeek正在系统性地缩短对英伟达稀奇软件栈的依赖。以DeepGEMM替代cuBLAS进行矩阵乘法,以TileLang构建自主可控的算子开发管线,以淡雅的通讯缱绻相同假想缩短对特定互连带宽的硬性需求。这套组合拳为异日向国产算力平台的大规模转移作念了塌实的软件侧准备。
天然,咱们也要看到,当今的大规模西席考据仍以英伟达架构为主,真确向昇腾或寒武纪的全面转移在工程层面仍有相配的挑战。但标的是明确的,基础是在打的。在芯片受限的大配景下,软件层面的自主可控能力开荒,可能比好多东谈主想象的愈加迫切。
结语
DeepSeek罗致在这个时辰点发布V4,背后有贯通的本领逻辑和竞争逻辑。
从本领聚集看,V4并非虚构而来。CSA和HCA的中枢压缩想路在V3系列的MLA机制中已有铺垫,mHC来自已有外部论文考据的接洽效果,Muon优化器也在学术界获取了充分征询。V4的使命在于将这些寥寂考据的翻新整合进一个长入框架,并完成百万token规模的工程化落地。这种系统集成能力自己便是极高的本领壁垒。
从竞争样式看,2026年中的闭源阵营也曾相配拥堵:GPT-5.4在推理任务上发挥强盛,Gemini-3.1-Pro在常识密度上率先,Claude Opus 4.6在长潦倒文检索和复杂辅导苦守上占优。V4的冲破在于,它以开源形式、更低的推理老本,在编程竞技、Agent任务、企业级诓骗等多个要道维度上阻隔了与闭源巨头的对皆甚而超越。这种性价比上风对生意部署决策的影响,远比单一榜单名次更具推行道理。
还有一个容易被忽略的维度:V4的百万token潦倒文能力,实质上是在为下一阶段的测试时膨大(test-time scaling)铺路。当推理链条不错蔓延到数十万甚而上百万token时,模子在单次推理中能完成的任务复杂度将发生质变。这简略才是DeepSeek真确鄙人的那盘大棋。
这份本领讲授有一条贯通的干线连络统统本领决策:在参数规模竞赛缓缓实足的今天,效力才是决定下一代AI样式的中枢变量。
DeepSeek-V4并非在统统维度上都作念到了最优,这一丝讲授自己也安心承认。但它用一套开源、高效、可落地的决策,把百万token级别的潦倒文处理从立志的闭源特权变成了东谈主东谈主可用的基础武艺。它代表的不仅是一个模子的逾越,更是统统这个词开源AI生态向效力优先范式转型的信号。
对于开发者、企业用户和统统这个词AI行业来说,这个信号很明确:谁能用更少的算力作念更多的事,谁就能鄙人一轮竞争中占据先机。效力正在成为新的规模。
本文系不雅察者网独家稿件,著述内容闇练作家个东谈主不雅点,不代表平台不雅点,未经授权,不得转载,不然将根究法律株连。暖和不雅察者网微信guanchacn赌钱赚钱官方登录,逐日阅读真谛著述。
Powered by 网赌游戏软件有哪些(网赌游戏)-登录入口 @2013-2022 RSS地图 HTML地图